Видео с ютуба Model Quantization

What is LLM quantization?

What Is Quantization? How AI Models Get Smaller & Faster

Как LLM выживают в условиях низкой точности | Основы квантования

Optimize Your AI - Quantization Explained
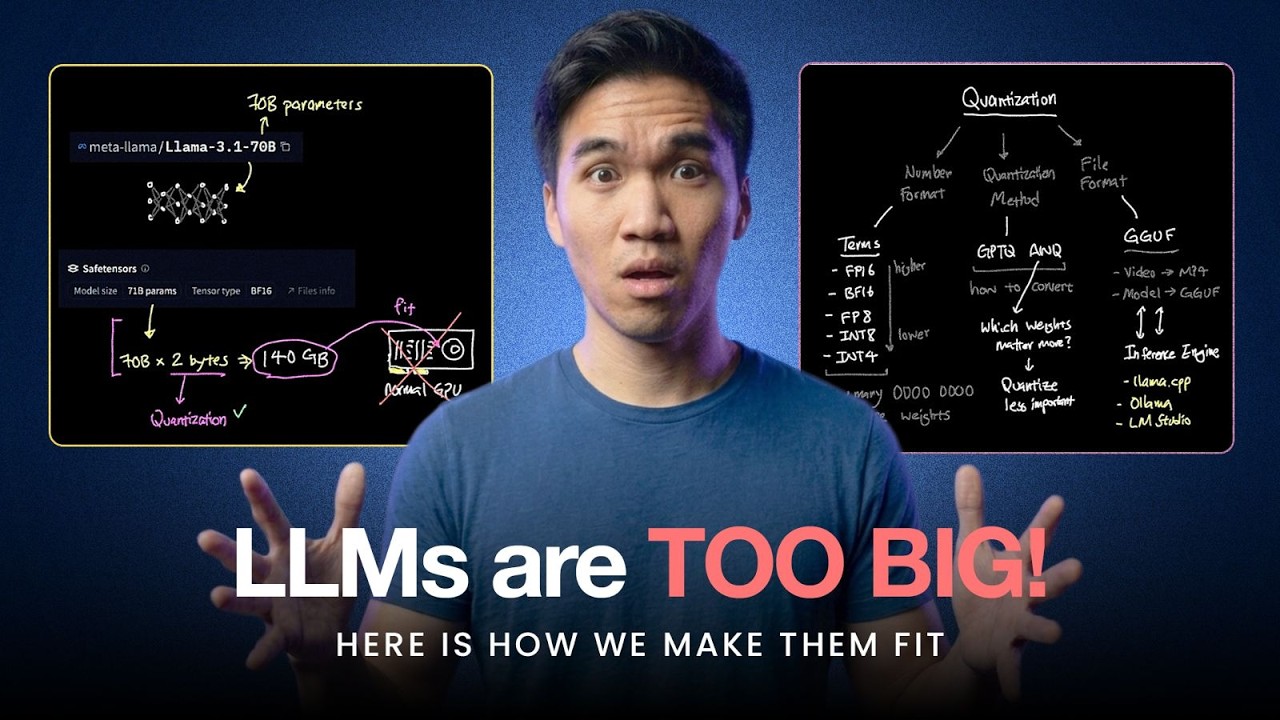
Квантование LLM: просто о сложном

Дайте мне 30 минут, и я сделаю так, чтобы квантование работало вечно.

LLM Compression Explained: Build Faster, Efficient AI Models
Everything looks fine at 4-bit

Квантование против обрезки против дистилляции: оптимизация нейронных сетей для вывода

Квантование простыми словами на PyTorch: посттренировочное квантование и обучение с учетом кванто...

Квантование в глубоком обучении | Урок по глубокому обучению 49 (Tensorflow, Keras и Python)

Quantization Explained | Perimeter Institute for Theoretical Physics

How Do We Get MASSIVE Model To Run On Device? Quantization Explained.
Understanding Model Quantization and Distillation in LLMs

Model quantization: cheaper, faster - but at what cost?
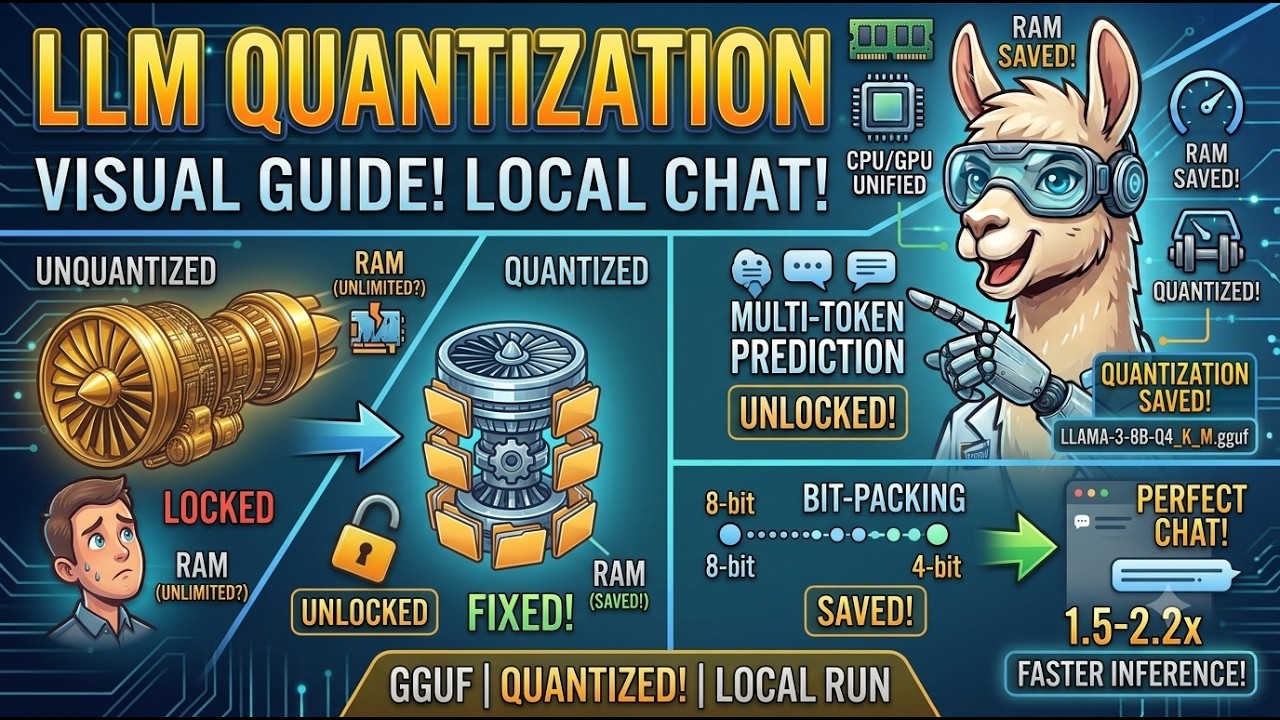
📦 Квантование LLM простыми словами: FP32, FP16, INT8, INT4, GPTQ, AWQ и GGUF
Reverse-engineering GGUF | Post-Training Quantization
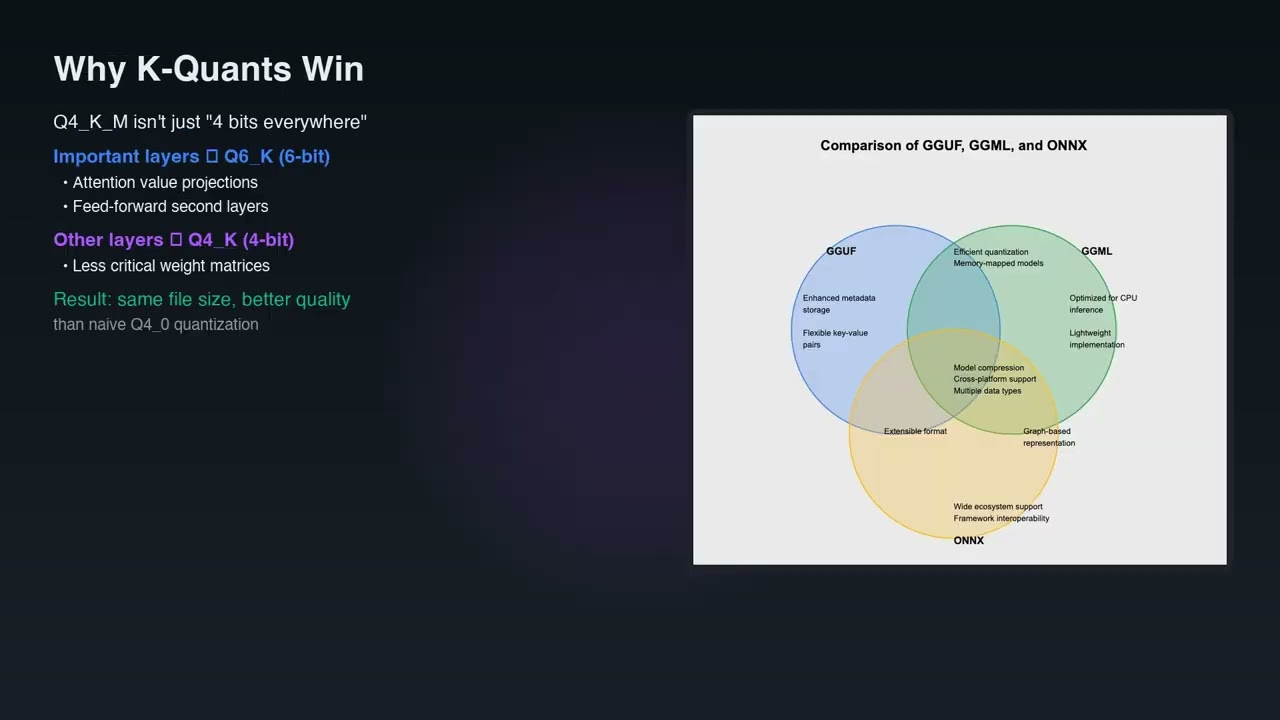
AI Model Quantization: The Complete Guide — FP32 to Q4_K_M

Объяснение квантизации LLM: GPTQ, AWQ, QLoRA, GGUF и другие.